[论文笔记] A Survey on Hallucination in Large Language Models: Principles, Taxonomy, Challenges, and Open Questions (2024.11)
一篇针对大模型幻觉的综述,覆盖了幻觉形成的原因、幻觉检测与缓解手段等内容。
幻觉的分类
事实性幻觉:输出与现实依据相互矛盾
事实性矛盾:实体错误、关系错误
事实性捏造:输出内容无法依据现有的世界知识进行验证
不可验证性幻觉:完全不存在,或是无法通过现有来源进行核实
过度捏造:由于主观偏见而缺乏普遍性
忠实性幻觉:与指令和上下文的一致性
指令不一致
上下文不一致:与用户提供的上下文不一致
逻辑不一致:LLM输出与内部逻辑不一致
幻觉的产生原因
数据:预训练数据、对齐数据中存在的以下问题
(1)错误或偏差:神经网络具有记忆训练数据的倾向,可能无意放大或强化训练数据中的错误信息和偏见;此外,还会受网络上模仿性虚假信息和社会性偏见影响而增强
(2)知识边界:主要包括出现频率较少的长尾数据,和训练数据的固有边界(如版权限制信息,和快速演变的世界知识)
(3)劣质的对齐数据:在SFT中引入新的世界知识和幻觉增加存在相关性;SFT中过于冗长复杂的指令也可能增强幻觉(EMNLP 2024)
训练
预训练:暴露偏差,在训练和推理时的情况不同,由于推理只能依据之前生成的内容进行预测,可能引起雪球效应增强幻觉
SFT:标注指令所需的知识超出模型的知识范围,且数据不允许模型拒绝回答
RLHF:谄媚,即模型以牺牲真实性为代价,迎合人类评估者
推理
解码策略中存在的缺陷:主流策略是随机采样,因为高似然序列往往生成出指令奇低的文本,但随机带来的多样性会增加幻觉风险,并随着温度增高而扩大
过度自信:源于对部分生成内容的过度关注
Softmax瓶颈:当输出词嵌入空间中的期望分布呈现出多个峰值的时候,LLM难以准确将所有峰值中的单词排列为最高概率的下一词;也就是说,模型希望表达的概率分布不一定是softmax所能表达的分布(ICLR 2026的研究表明softmax瓶颈未必会影响对top-p的采样,因此对模型的影响仍需探讨,The Softmax Bottleneck Does Not Limit the Probabilities of the Most Likely Tokens)
Softmax bottleneck 指 linear LM head 将 d 维 hidden representation 映射到 V 维 vocabulary distribution 时产生的低秩约束,使模型无法表示任意高秩的真实条件分布;它在现代 LLM 中结构上仍然存在,但 ICLR 2026 的结果表明这种限制未必显著影响实际生成所依赖的 top-token probabilities,因此目前缺乏证据把它视为现代 LLM hallucination 的主要来源。
推理失败
幻觉检测手段分类
事实性幻觉检测
事实核查:根据可信来源进行验证,包括事实抽取和事实验证两个步骤
不确定性估计:通过模型内部信号来进行检测,分为基于LLM内部状态和内部行为的方法
前提:LLM幻觉的根源与模型内部状态的不确定性存在联系
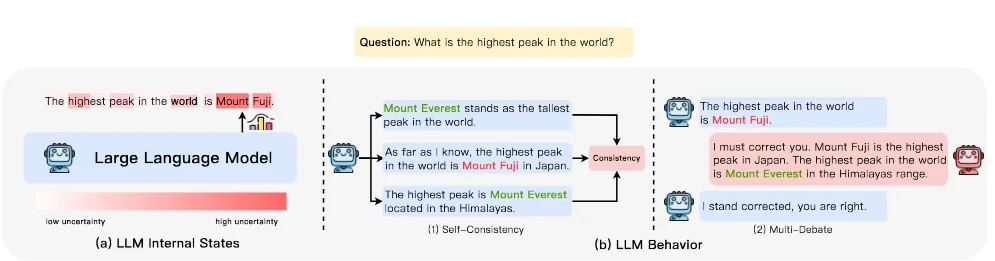
基于内部状态:Varshney,检测关键概念的最小token概率;Yao,测量第一个token的熵,设定阈值来判断幻觉
基于LLM行为:无需访问内部状态,可以用于闭源模型。例如,
直接查询:Manakul从同一个prompt中采样多个回答,评估其一致性
间接查询:提出开放性问题来引出特定信息,并对其一致性进行评估。此外,还有基于multi-agent的方法,引入一个审查LLM进行评估
忠实性幻觉检测
指标分类:
事实based:例如测量output和gt的n-gram/关系三元组重叠率
分类器based:训练一个分类器,判别输出内容是否蕴含于prompt
QA based:先从输出内容中抽取结论性的句子,根据对应输出重构问题,再基于原始文本中回答问题,比较这一回答与输出内容是否一致
uncertainty based:幻觉通常与高不确定性正相关。部分文章会通过条件熵(van der Poel,EMNLP 2022)、长度归一化的对数概率等衡量模型置信度;此外,幻觉token并不一定对应低置信度,它可能是某段错误事实的延续,因此可能具有高概率,abs/2305.14540探讨了这种幻觉级联现象。
LLM based:基于LLM进行忠实性幻觉的自动评估,令其输出二元分类,或是k-point Likert scale(打分)
幻觉数据集
分类:幻觉评估数据集,用于评估模型是否会生成幻觉;幻觉检测数据集,用于评估幻觉检测方法方法能否识别模型生成的幻觉
幻觉缓解
缓解data-based幻觉
data filtering:在预训练阶段对数据进行过滤;不仅是对数据来源进行过滤,还包括对数据进行去重以防止过拟合
model editing:通过引入新的知识来纠正模型行为;可以在无需大量训练的情况下对模型参数进行修改,但难以应对大规模更新,且可能对模型的整体性能造成影响
locate-then-edit:定位模型参数中“错误”的部分,然后对这部分参数进行更新。但Yao等人认为这类方法泛化性不足,在不同模型架构中的性能存在差异。
meta-learning:训练一个编辑器模型,在看到一条待修改的知识后,预测原模型参数如何进行修改;
RAG:通过外部内容检索辅助模型生成
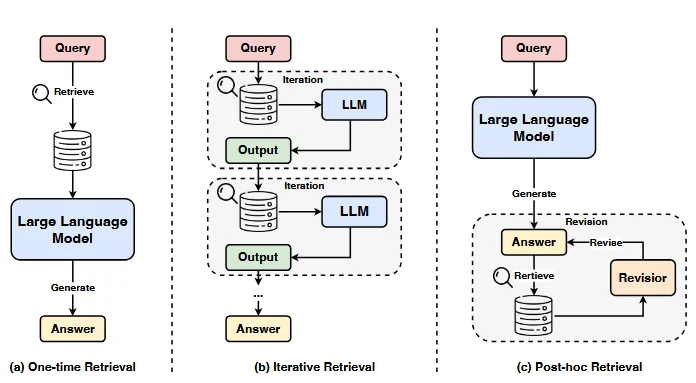
缓解training-related幻觉
缓解inference-related幻觉
事实性增强解码:在解码的过程中优先考虑生成信息的可靠性,分为事实性解码和后编辑解码
忠实性增强解码:
上下文一致性:分为两条研究路线。第一条是上下文感知解码,通过放大有无上下文之间的输出概率差异(KL散度),并基于此来动态调整采样温度,引导模型更加关注上下文;另一条路线是知识约束解码,在生成过程中识别幻觉,并对内部状态进行重新加权,以消除幻觉。此外,还有研究探讨了克服softmax瓶颈的方法。
逻辑一致性:增强思维链内部的一致性。一部分研究会通过对比解码生成知识蒸馏数据,这样可以减少表层复制现象。此外,还有采用符号思维链的研究,要求模型进行逻辑推理而非自然语言推理。